1 Millón y contando

Saint Gobain
NASA
Time Warner Cable
Loreal Paris
Siemens
DHL

Consigue una visibilidad completa del balanceador de carga con OpManager

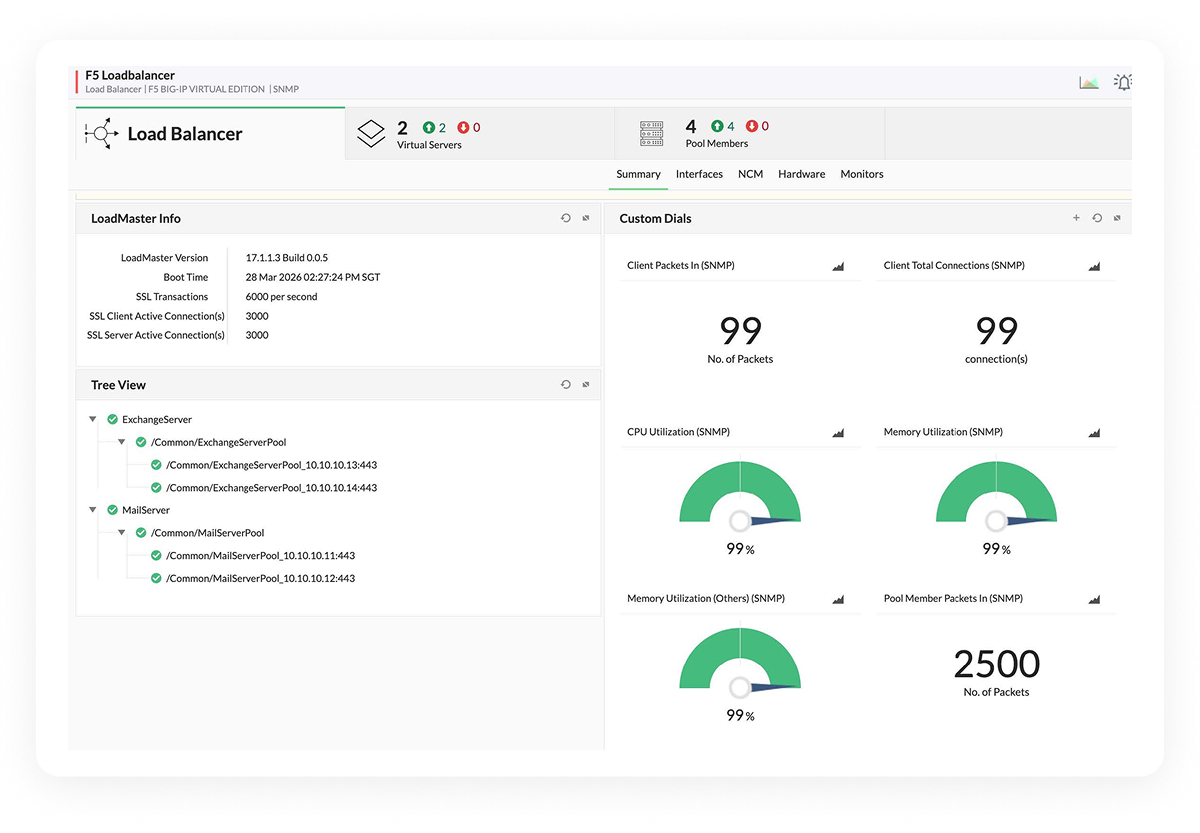
La supervisión fragmentada entre entornos en la nube y locales obliga a los equipos a hacer malabarismos con múltiples herramientas, lo que facilita que se pasen por alto las primeras señales de alerta. Cuando un balanceador de carga se convierte en un cuello de botella o falla, puede provocar la caída de aplicaciones enteras, y la mayoría de las herramientas solo detectan los problemas una vez que los usuarios ya se han visto afectados. ManageEngine OpManager resuelve este problema correlacionando el estado del balanceador de carga con el rendimiento de los servidores de fondo en una única vista unificada, lo que ayuda a los equipos a detectar los problemas de forma temprana, comprender su impacto en tiempo real y resolverlos más rápidamente sin tener que cambiar de panel de control ni recopilar datos manualmente.

Supervisa el estado real del servicio, no solo el tiempo de actividad de los dispositivos

  • Detecta los errores antes de que los detecten tus usuarios:

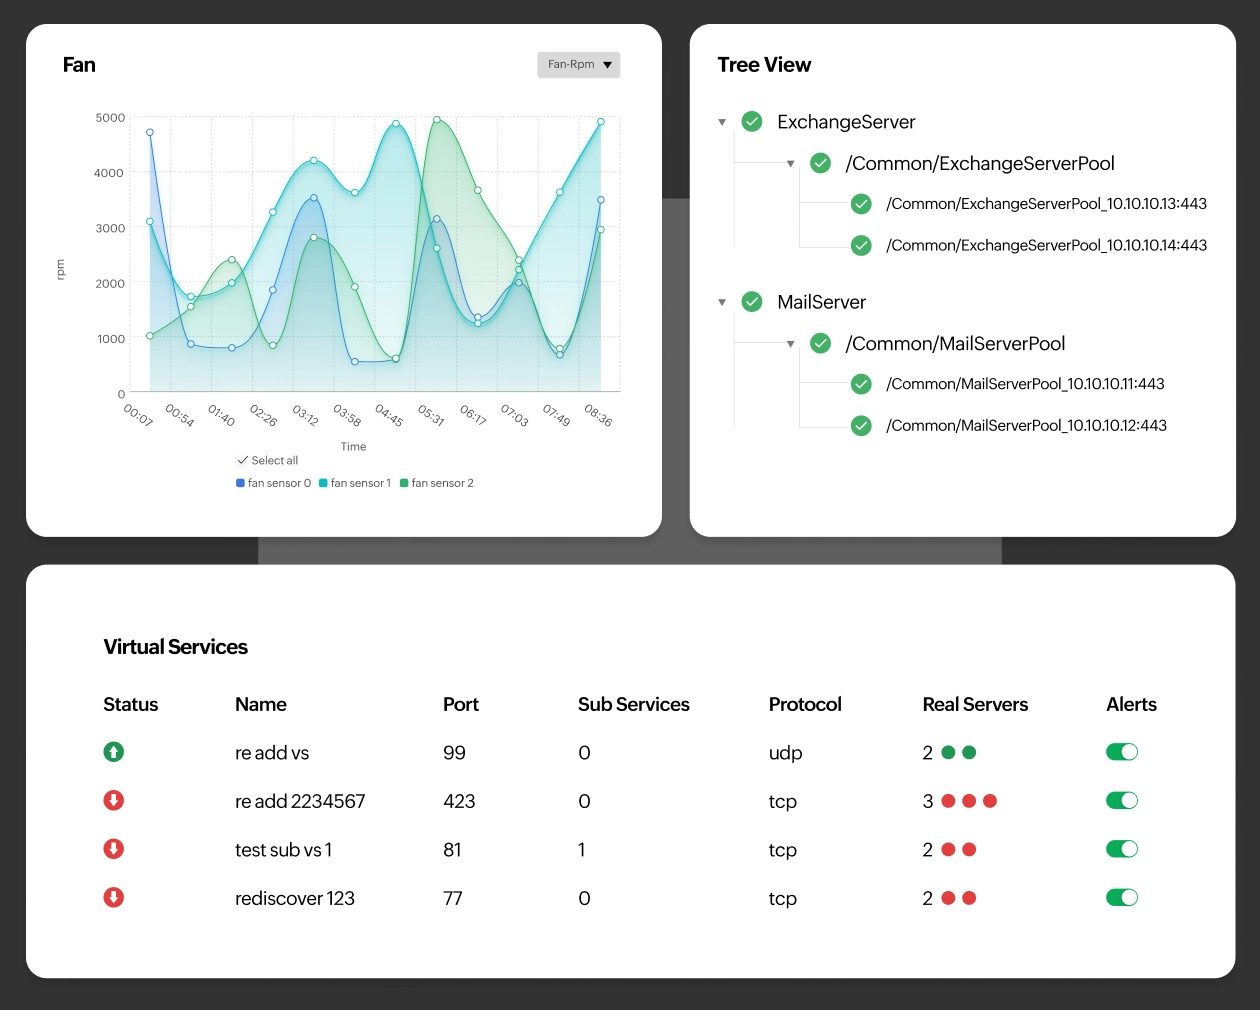
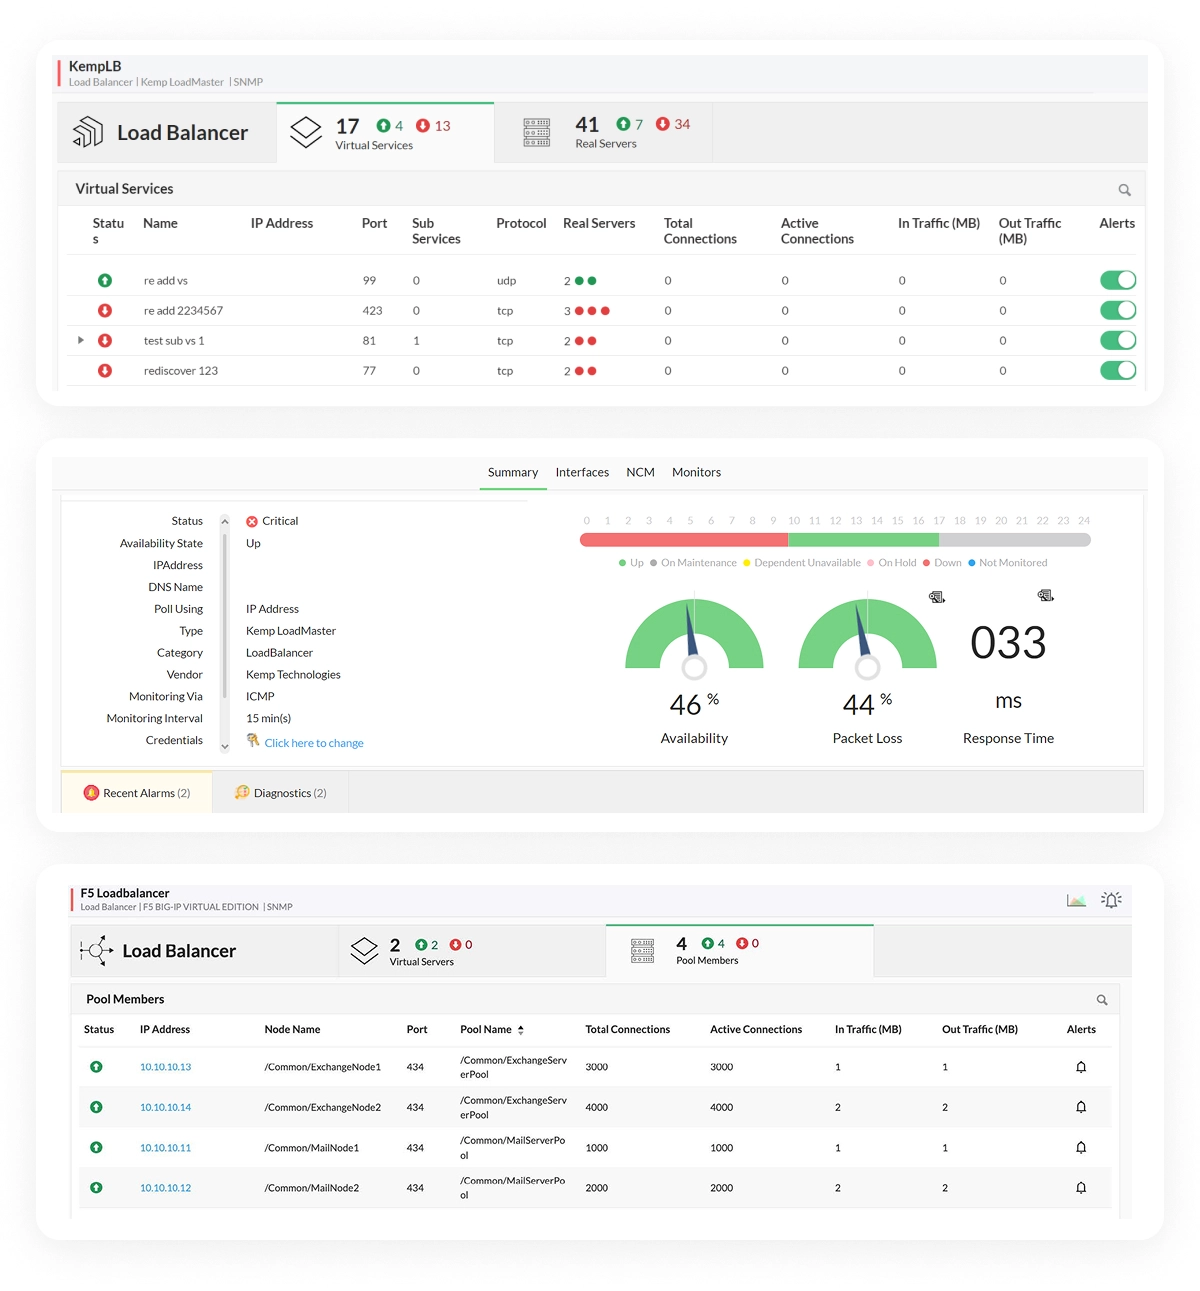
    OpManager supervisa los servicios específicos que hay detrás de tu balanceador de carga (como los puertos TCP, las URL HTTP y los servicios FTP), y no solo el propio dispositivo. Si el servidor web está en funcionamiento pero el grupo de aplicaciones está inactivo, se te avisa de inmediato, lo que evita que tu servicio de asistencia técnica se vea desbordado por llamadas del tipo "¿Está caído el sitio web?".

  • Acaba con el caos del "a mí me funciona":

    Obtén un estado de salud en tiempo real de cada miembro del grupo. Sabrás al instante qué servidores están gestionando realmente el tráfico y cuáles están inactivos, pero siguen apareciendo como "en línea" en las herramientas básicas de supervisión.

  • Cumple los SLA con precisión quirúrgica:

    Demuestra el tiempo de actividad a tus partes interesadas con informes de disponibilidad detallados. Cuando un cliente reclame un periodo de inactividad, dispondrás de los datos necesarios para demostrar exactamente cuándo estuvieron disponibles los servicios y cómo se redirigió el tráfico.
Monitor real service health, not just device uptime
Track the metrics that predict performance issues and failures

Realiza un seguimiento de los indicadores que permiten predecir problemas de rendimiento y fallos

  • Detecta los cuellos de botella antes de que se produzca un fallo:

    Realiza un seguimiento de las conexiones activas y el rendimiento en tiempo real. Si un servidor gestiona el 80 % del tráfico mientras los demás permanecen inactivos, podrás detectar el desequilibrio de carga inmediatamente antes de que ese servidor se vea desbordado y provoque la caída de la aplicación.

  • Deja de perseguir fantasmas gracias a la visibilidad a nivel de paquete:

    Cuando los usuarios se quejen de que las aplicaciones van lentas, analiza directamente los errores de paquetes y las tasas de solicitudes HTTP. Sabrás al instante si el problema radica en la configuración del balanceador de carga, en el servidor backend o en la propia red.

  • Protege tu inversión en infraestructura física:

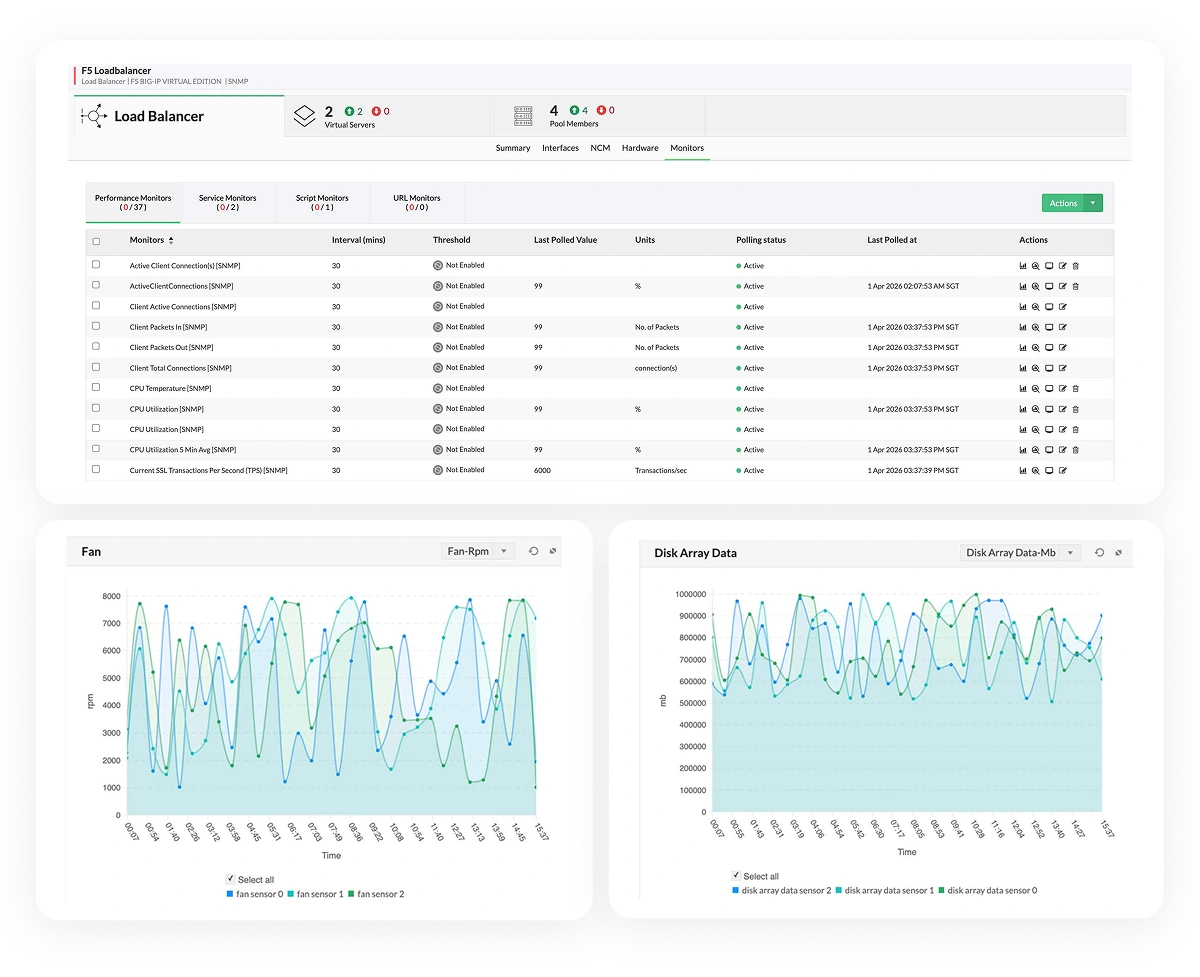
    Supervisar los parámetros clave del hardware, como la temperatura de la CPU y la velocidad de los ventiladores, en tus dispositivos F5. Evita fallos catastróficos de hardware que requieran sustituciones de emergencia y mantenimiento no planificado. windows.

Convertir los datos de rendimiento en señales de alerta temprana

Las redes modernas no fallan sin previo aviso, sino que primero muestran señales sutiles. Al analizar continuamente las métricas en tiempo real del balanceador de carga como las conexiones, la latencia y el rendimiento, puedes detectar anomalías de forma temprana y darte cuenta de cuándo algo no va bien. En lugar de reaccionar ante las interrupciones del servicio, adquieres la capacidad de actuar ante las primeras señales, evitando así las interrupciones antes de que afecten a tus usuarios.

Metricas¿Por qué es importante para ti?
Conexiones activasConoce con exactitud y en tiempo real la carga que soporta tu infraestructura. Detecta los picos de tráfico antes de que saturen los servidores y provoquen interrupciones del servicio.
Tasa de conexión (Nueva/SYN)Detecta al instante los ataques DDoS o los picos repentinos de tráfico. Activa las defensas automáticas antes de que los usuarios se vean afectados.
Número de conexiones fallidasUn pico indica que los servidores están rechazando conexiones. Identifica rápidamente problemas de estado del backend o sobrecarga del balanceador de carga.
Conexiones actuales y máximasTe ayuda a ajustar el tamaño de la infraestructura. Si alcanzas constantemente los límites, significa que es hora de ampliarla; un uso reducido implica un desperdicio de capacidad.
Rendimiento (entrada/salida — bytes)Realiza un seguimiento del volumen de datos que pasa por tu balanceador de carga. Identifica las aplicaciones que consumen mucho ancho de banda y evita la congestión de la red.
Latencia y tiempo de respuestaMide la rapidez con la que se procesan las solicitudes. Incluso los pequeños retrasos pueden afectar a la experiencia del usuario y a las conversiones.
Errores de paquetes (perdidos/retransmitidos)Detectar problemas a nivel de red. Las tasas de error elevadas suelen indicar errores de configuración o problemas físicos en la red.
Frecuencia de solicitudes HTTP (por segundo)Comprender los patrones de tráfico de las aplicaciones. Realizar un seguimiento del crecimiento, las caídas y los picos inesperados en las solicitudes de los usuarios.
Estado de salud de los miembros del grupoSupervisa el estado de los servidores backend. Comprueba rápidamente cuántos servidores están disponibles y cuántos han fallado.
Estado del hardware (temperatura/ventilador/fuente de alimentación)Evita las interrupciones del servicio relacionadas con el hardware. Detecta a tiempo los componentes que se sobrecalientan o que presentan fallos.
Connect the dots between the load balancer and what's behind it

Establece una conexión entre el balanceador de carga y lo que hay detrás de él

  • Reduce el tiempo dedicado a la resolución de problemas de horas a minutos:

    Cuando falla un miembro del grupo, se ve inmediatamente si se trata de un fallo del servidor (CPU al 100 %), un problema de disco (disco lleno) o un problema de red. Ya no hace falta iniciar sesión en cinco sistemas diferentes para encontrar la causa raíz.

  • Visualiza toda la pila de la aplicación:

    Los mapas de topología de OpManager superponen el estado de los servidores de fondo directamente sobre la vista del balanceador de carga. De un solo vistazo, puedes ver exactamente qué servidores están teniendo problemas y cómo eso afecta a la distribución del tráfico.

  • Evitar fallos en cadena:

    Cuando un servidor backend empieza a fallar, OpManager relaciona ese fallo con el aumento de las tasas de error en el balanceador de carga. Recibes una sola alerta que te indica exactamente dónde debes buscar, en lugar de 50 alertas sobre los síntomas.

Reduce el tiempo de inactividad con alertas proactivas y flujos de trabajo automatizados

  • Acaba de una vez por todas con la fatiga por alertas:

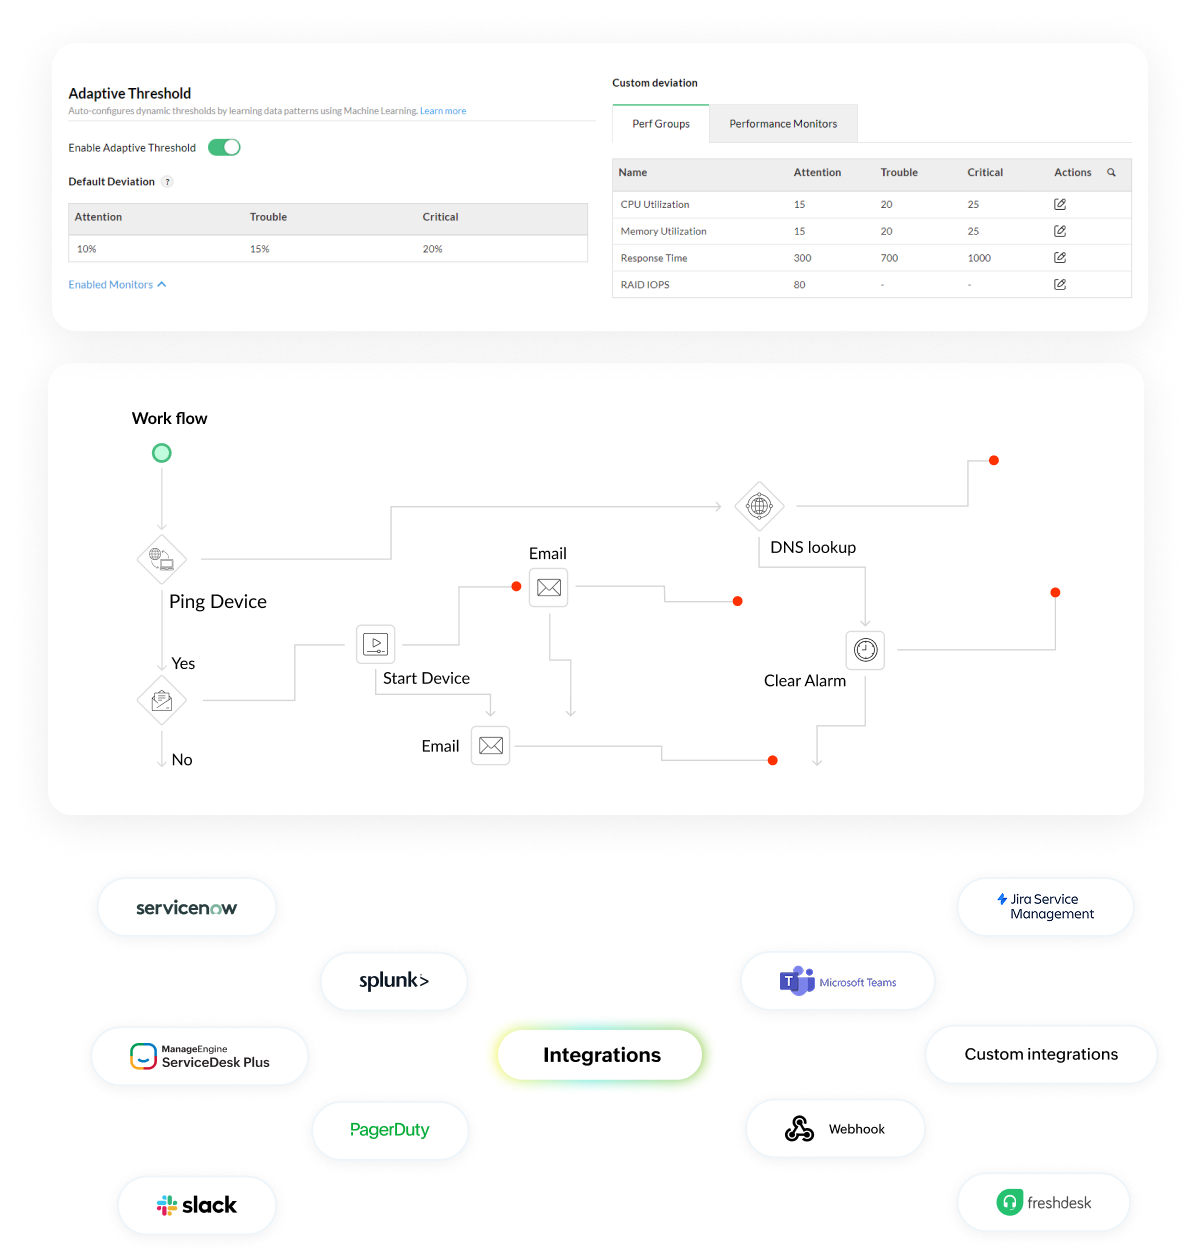
    OpManager aprende a identificar qué se considera "normal" en tu entorno. En lugar de despertarte a las 3 de la madrugada por un pico rutinario en el uso de la CPU, OpManager solo te avisa cuando el tráfico se desvía significativamente de la línea de referencia, como por ejemplo un aumento del 50 % en las conexiones que indique un problema real.

  • Automate the fix, not just the notification:

    Trigger no-code workflows that act the moment an issue is detected. When a pool member fails, OpManager can automatically execute predefined actions like restarting services, running remediation scripts, or creating tickets, reducing manual intervention and speeding up recovery.

  • Intégralo con las herramientas que ya utilizas:

    Crea automáticamente tickets de ServiceNow, avisa a tu equipo a través de Slack y activa flujos de trabajo de corrección. OpManager también se integra con herramientas como Ansible para ejecutar guiones, lo que te permite responder más rápido sin tener que modificar tu configuración actual.

Reduce downtime with proactive alerts and automated workflows

Supervisión de equilibradores de carga de distintos fabricantes con OpManager

OpManager es compatible con los principales controladores de entrega de aplicaciones, como F5, Citrix, Radware, Fortinet y Cisco, así como con dispositivos basados en SNMP, en entornos híbridos.

Proveedores de equilibradores de carga y ADC compatibles

  • F5 Networks (BIG-IP, VIPRION, VELOS, BIG-IQ)
  • Citrix Systems (NetScaler / ADC, SD-WAN)
  • Cisco Systems (Serie WAVE)
  • Radware (Serie Alteon)
  • Fortinet (FortiADC)
  • Symantec (Serie ProxySG / SG)
  • IBM (BladeCenter, Flex, IMM)
  • Nortel Networks (Conmutadores Alteon)
  • Coyote Point Systems (Serie Equalizer)

Otros dispositivos de infraestructura compatibles

  • ForeScout Technologies
  • Gigamon
  • Juniper Networks
  • NetApp
  • Riverbed Technology
  • Opengear
  • Sangfor Technologies

Problemas habituales con los equilibradores de carga y cómo resolverlos

Resiliencia del tráfico
Estado del backend
Visibilidad unificada

Los picos de tráfico están provocando fallos en tus aplicaciones

Escenario

Los picos de tráfico que se producen durante las campañas, las ofertas relámpago o las horas de mayor uso provocan un aumento repentino de las solicitudes de los usuarios, lo que ejerce una intensa presión sobre el balanceador de carga. Sin una visión clara de la distribución del tráfico y la capacidad del backend, el balanceador de carga tiene dificultades para gestionar el volumen, lo que da lugar a una distribución desigual de la carga y a una merma del rendimiento.

Impacto

Los tiempos de respuesta lentos, las solicitudes fallidas y las transacciones perdidas afectan directamente a los ingresos y a la confianza de los usuarios.

¿Cómo ayuda OpManager?

Supervisa las conexiones activas, las tasas de solicitudes y la latencia en tiempo real, avisando de situaciones de sobrecarga y estableciendo una correlación con el estado del backend, de modo que los equipos puedan actuar antes de que los usuarios se vean afectados.

Los fallos en los servidores backend están perjudicando a los usuarios de forma silenciosa

Escenario

Los servidores individuales del grupo del balanceador de carga empiezan a presentar un deterioro debido al agotamiento de recursos, a problemas de configuración o a fallos parciales. Dado que el tráfico sigue dirigiéndose a estos nodos, el problema permanece oculto al no existir una visibilidad clara del estado de los servidores de fondo en todo el grupo.

Impacto

Errores intermitentes, fallos al iniciar sesión y una experiencia de usuario irregular que resulta difícil de detectar y solucionar.

¿Cómo ayuda OpManager?

Realiza un seguimiento del estado de los miembros del grupo y de las conexiones fallidas, identificando claramente los nodos que no funcionan correctamente y correlacionándolos con los indicadores de rendimiento, lo que reduce el tiempo de resolución de problemas y evita que el impacto se prolongue.

No dispones de una visión global de tus
balanceadores de carga

Escenario

Los balanceadores de carga distribuidos entre entornos en la nube y locales se supervisan mediante herramientas independientes, cada una de las cuales ofrece una visibilidad limitada. Esto obliga a los equipos a alternar entre varios paneles de control para comprender el flujo de tráfico y el rendimiento del backend, lo que dificulta obtener una visión global.

Impacto

Un MTTR más prolongado, una resolución de problemas fragmentada y un retraso en la identificación de la causa raíz.

¿Cómo ayuda OpManager?

Ofrece una visibilidad unificada e independiente del proveedor, de modo que los equipos puedan supervisar el rendimiento, el tráfico y el estado del backend desde un único lugar y resolver los problemas con mayor rapidez.

Preguntas frecuentes sobre la supervisión de los balanceadores de carga

¿Puede OpManager supervisar los balanceadores de carga en la nube y locales desde un único lugar?


Sí. OpManager es compatible con plataformas en la nube como AWS, Azure y GCP a través de API, y con dispositivos locales a través de SNMP, lo que te ofrece una visión unificada de tu infraestructura híbrida de balanceadores de carga sin necesidad de cambiar de herramienta.

¿Es compatible OpManager con balanceadores de carga como Citrix NetScaler y F5 BIG-IP?


¿Cómo reduce OpManager el exceso de alertas en la supervisión de los balanceadores de carga?


¿Es OpManager adecuado tanto para empresas como para equipos en expansión?


¿Y si tu balanceador de carga nunca se convirtiera en tu cuello de botella?

Solicita una demostración para ver cómo los equipos de TI utilizan OpManager para supervisar los balanceadores de carga, detectar fallos de forma temprana y resolver los problemas antes de que afecten a los usuarios.

Al hacer clic en 'Enviar', aceptas el tratamiento de tus datos personales de conformidad con la Política de privacidad.

Elegido por clientes de todo el mundo


“Fácil implementación, excelente asistencia técnica y una herramienta más económica —Jefe de equipo, sector de servicios informáticos”

Función del revisor: Infraestructura y operaciones

Tamaño de la empresa: entre 500 millones y 1.000 millones de dólares estadounidenses

Llevamos utilizando OpManager desde 2011 y nuestra experiencia general ha sido excelente. La herramienta desempeña un papel fundamental a la hora de aportar valor a nuestra organización y a los clientes a los que prestamos asistencia. El servicio de asistencia es excelente y el personal asume plenamente la responsabilidad de resolver los problemas. La innovación es constante y se aprecia claramente en las nuevas versiones.

“OpManager: 10 pasos por delante de la competencia, a un paso de no tener rival — Responsable de servicios de red, organización pública”

Función del revisor: Infraestructura y operaciones

Tamaño de la empresa: entre 5.000 y 50.000 empleados

Mi relación con ManageEngine viene de lejos. A OpManager siempre le han faltado una o dos funciones que lo convertirían realmente en la mejor herramienta del mercado, pero, a pesar de ello, es el producto más completo y fácil de usar que hay en el mercado.

“Fácil implementación con un catálogo repleto de funciones; el servicio de asistencia técnica tiene margen de mejora —Responsable del centro de operaciones de red (NOC), sector de servicios de TI”

Función del evaluador: Gestión de programas y carteras

Tamaño de la empresa: entre 500 millones y 1.000 millones de dólares estadounidenses

El proveedor nos ha prestado su apoyo durante las fases de implementación y de prueba de concepto (POC), proporcionándonos licencias de prueba. Por lo general, responde con rapidez a las solicitudes de nuevas funciones y a los comentarios. El apoyo del proveedor durante la fase de implementación fue suficiente. Tras la puesta en marcha, el soporte técnico es más que adecuado, aunque el proveedor podría introducir algunas mejoras.

“Una herramienta de supervisión estupenda —Director de Sistemas de Información del sector financiero”

Cargo del evaluador: Director de Sistemas de Información (CIO)

Tamaño de la empresa: entre 1.000 y 3.000 millones de dólares estadounidenses

ManageEngine ofrece un conjunto de herramientas que han mejorado la disponibilidad de nuestras aplicaciones internas. Gracias a sus funciones de supervisión, gestión y alertas, hemos podido alcanzar el máximo rendimiento en nuestro centro de datos.

“Fácil de implementar y de usar. Muy intuitivo. — Ingeniero jefe de servicios de TI”

Función del evaluador: Arquitectura empresarial e innovación tecnológica

Tamaño de la empresa: entre 250 y 500 millones de dólares estadounidenses


ManageEngine support was responsive to all our queries.

Capterra
Getapp
Software Advice
G2
Marcus Maravilla

“OpManager es una herramienta intuitiva, fácil de usar y que nos proporciona la visibilidad de red que necesitamos. Además, el equipo de soporte de ManageEngine ha sido excepcional: ha resuelto el 99 % de nuestras consultas de forma rápida y efectiva.”

Marcus Maravilla

Gerente de Networking, PriceSmar

Luis Orlando Vargas

“OpManager nos proporciona la visibilidad y el control que necesitamos sobre nuestra infraestructura TI. Su facilidad de configuración, monitoreo y alertamiento nos ha permitido gestionar incidentes, capacidades y eventos de manera sencilla y eficiente."”

Luis Orlando Vargas

Coordinador de Infraestructura TI, Refinancia

 
Zona de videos
OpManager Customer Videos
Conociendo ManageEngine OpManager
  • opm-video2Empresas Fonalledas monitorea su red con OpManager
    opm-video3Institución financiera de Ecuador gestiona sus redes con OpManager
  • opm-video4César Iglesias administra sus redes y operaciones de TI con OpManager
    opm-video5BAC Honduras logró visibilidad completa de su infraestructura con OpManager
  • opm-video4Assertus gestiona y protege su red con OpManager y EventLog Analyzer