Mais de 5.000 empresas confiam no OpManager

Saint Gobain
NASA
Time Warner Cable
Loreal Paris
Siemens
DHL

Principais recursos de monitoramento de servidores com suporte do OpManager

O OpManager conta com mecanismos baseados em agente e sem agente para monitorar dispositivos de servidor. Depois de varrer a rede e descobrir os dispositivos, o OpManager identifica os servidores e os classifica com base em fatores como fornecedor, tipo e função. É possível monitorar o uptime do servidor, os processos e os serviços, além de métricas principais como uptime, CPU, memória, processos, serviços e espaço em disco. Vamos conhecer cada um desses recursos.

Garanta uptime 24/7 com o monitoramento de disponibilidade de servidores

Garanta alta disponibilidade dos servidores com verificações regulares de uptime. OpManager usa ICMP, SNMP e TCP para verificar a disponibilidade dos dispositivos e mantém uma linha do tempo de disponibilidade para cada um. É possível personalizar o intervalo de monitoramento das verificações de uptime e configurar alarmes de indisponibilidade. Além disso, é possível acompanhar o tempo de resposta e a perda de pacotes para assegurar a qualidade e a disponibilidade.

Garanta uptime 24/7 com o monitoramento de disponibilidade de servidores
Tenha uma visão do desempenho dos servidores acompanhando KPIs

Tenha uma visão do desempenho dos servidores acompanhando KPIs

Acompanhe o desempenho dos servidores com monitores de desempenho dedicados e específicos por fornecedor para métricas como CPU, memória, tráfego, temperatura da CPU e espaço em disco. O OpManager permite configurar thresholds de alarme em três níveis para as métricas monitoradas e gerar alarmes e gráficos ricos em contexto com base nos dados de desempenho.

Gerencie serviços e processos críticos sem esforço

Receba alarmes instantâneos de processos e interrupções de serviços. É possível usar o OpManager para obter todos os processos e serviços ativos nos servidores e configurar verificações de monitoramento regulares para eles. Quando algum processo ou serviço não está em execução, o alarme informa a interrupção, o processo ou serviço e o dispositivo. Também é possível configurar o OpManager para encerrar e reiniciar serviços ou processos remotamente.

Gerencie serviços e processos críticos sem esforço
Visualize arrays de servidores e data centers

Visualize arrays de servidores e data centers

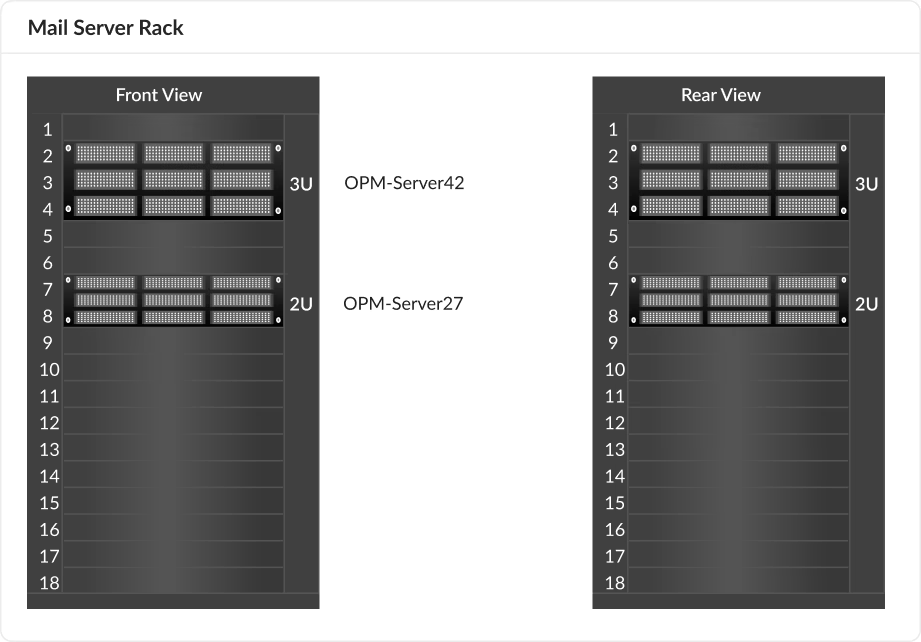
Fique de olho nos racks de servidores para ampliar os recursos de monitoramento. É possível mapear racks de servidores com construtores de racks, mapear plantas de data centers, hosts virtuais e VMs, topologias de camada 2 e muito mais com os recursos de mapeamento de servidores do OpManager. Também é possível usar dashboards e gráficos para analisar o desempenho dos servidores de relance. Os dashboards e gráficos usam códigos de cores e marcação de data e hora nas informações dos servidores para gerar insights rápidos e acionáveis.

Use a resposta automatizada a incidentes para resolver problemas de servidores

Evite downtime e interrupções prolongadas com os workflows automatizados do OpManager. É possível criar ações de workflow sequenciais e baseadas em resultados. O OpManager oferece mais de 70 ações em um construtor de workflows sem código, com recurso de arrastar e soltar. Basta organizar cada ação com base no resultado da anterior para criar um workflow de remediação intuitivo. No caso de servidores, os workflows podem executar ações como reiniciar serviços, provisionar VMs, executar scripts e muito mais.

Use a resposta automatizada a incidentes para resolver problemas de servidores
Mantenha vigilância constante dos servidores monitorando logs

Mantenha vigilância constante dos servidores monitorando logs

Monitore logs de servidores como logs de eventos do Windows e Syslogs para ter visibilidade permanente dos servidores. É possível configurar alarmes para logs de eventos específicos do Windows e criar regras para receber alertas sobre os Syslogs correspondentes. Também é possível monitorar logs de aplicações com regras pré-configuradas para servidores Exchange, IIS, MS SQL e ISA.

O que torna único o monitoramento de servidores com o OpManager?


Gerenciamento de servidores orientado por ML

O OpManager conta com um poderoso mecanismo de ML que usa algoritmos avançados para prever o desempenho dos sistemas monitorados. Com thresholds adaptativos, é possível usar o OpManager para calcular, definir e ajustar os thresholds de alarme de todas as métricas monitoradas. Isso melhora a detecção de anomalias e elimina o excesso de alarmes (alarm flooding) e os falsos positivos.


Suporte ao monitoramento multifornecedor

Monitore e gerencie, sem esforço, o ambiente multifornecedor, incluindo servidores físicos e virtuais, em um console unificado com o OpManager. Gerencie com facilidade servidores físicos dos principais fornecedores, como Dell, HP, IBM, Huawei, Oracle e Lenovo, além de servidores virtuais de plataformas como VMware, Hyper-V, Nutanix, Xen e Proxmox.


Monitoramento de servidores completo (MSSQL, Exchange, DC, IPMI)

Seja para executar operações de banco de dados, hospedar aplicações, e-mail ou gerenciar domínios, o OpManager consegue monitorar os servidores. É possível monitorar controladores de domínio, usar IPMI para gerenciar o hardware de servidores, acompanhar transações do MS SQL, monitorar servidores Exchange e monitorar diferentes servidores com métricas dedicadas.

Quais são as principais métricas de desempenho de servidores a observar?

  • Utilização de
    CPU ou memória:
    Porcentagem de CPU ou RAM em uso. É possível configurar thresholds de alarme para valores mais altos, a fim de evitar gargalos, baixo desempenho ou escassez de recursos.
  • Transações
    ativas:
    Número de operações em andamento no servidor. Ajuda a identificar carga, possíveis deadlocks ou processos lentos que afetam o desempenho.
  • Uso de largura
    de banda de rede:
    Quantidade de dados transferidos pela rede. Um uso elevado indica tráfego intenso, saturação ou operações de transferência de dados.
  • Tamanho dos
    arquivos de dados:
    Tamanho acumulado dos arquivos de dados de aplicações/bancos de dados. É possível acompanhar o crescimento para realizar o planejamento de capacidade.
  • Taxa de perda
    de pacotes:
    Porcentagem de pacotes de dados que não chegam ao destino. Taxas altas indicam problemas de rede.
  • Conexões ativas de
    banco de dados:
    Número de conexões abertas com o banco de dados. Contagens altas indicam demanda das aplicações, problemas de pool de conexões ou limites de recursos.
  • Taxa de erros
    de interface:
    Porcentagem de erros em interfaces de rede. Taxas altas sugerem problemas físicos de rede, que afetam a conectividade do servidor.
  • Logins
    por segundo:
    Taxa de autenticações no servidor. Picos podem indicar alta demanda ou possíveis ameaças de segurança.
  • Taxa de leitura e
    gravação de I/O:
    Velocidade das operações de leitura/gravação em disco. Taxas altas sugerem aplicações limitadas por disco ou gargalos de I/O.
  • Transações
    por segundo:
    Número de operações do servidor concluídas por segundo. Indica o throughput do servidor e a capacidade geral de desempenho.
  • Total de
    locks ativos:
    Número de locks mantidos em recursos do servidor. Contagens altas indicam contenção, baixa concorrência ou possíveis deadlocks.
  • Porcentagem usada de
    arquivos de log:
    Espaço em disco consumido por arquivos de log. É possível configurar monitores para garantir a rotação e o arquivamento de logs e evitar o esgotamento do espaço em disco.
  • Latência média
    de disco:
    Tempo médio das operações de I/O em disco. Latência alta indica baixo desempenho do disco, o que afeta a capacidade de resposta das aplicações.
  • Tempo médio de
    espera por locks:
    Tempo médio que os processos aguardam por locks. Tempos de espera altos indicam contenção de recursos, o que leva à degradação do desempenho.
  • Detalhes das partições
    do dispositivo:
    Informações sobre as partições de disco do servidor. Ajuda no planejamento de capacidade, na identificação de desequilíbrios e no gerenciamento de espaço.
  • Número de deadlocks
    por segundo:
    Frequência de deadlocks. Taxas altas afetam gravemente o desempenho das aplicações e exigem resolução imediata.
  • Espaço de
    dados do BD:
    Espaço total em disco consumido pelo banco de dados. Monitore o crescimento para realizar o planejamento de capacidade e o gerenciamento eficiente do banco de dados.
  • Contagem de
    instâncias:
    Número de instâncias de aplicações/serviços em execução. Ajuda a garantir escalabilidade, alocação de recursos e disponibilidade de serviços..
  • Taxa de acertos de
    cache (cache hit ratio):
    Porcentagem de solicitações atendidas pelo cache. Uma taxa alta indica cache eficiente, respostas mais rápidas e carga reduzida.
  • Contagem de
    threads:
    Número total de threads/processos ativos. Contagens altas podem indicar contenção de recursos, código ineficiente ou esgotamento de memória.

Como funciona o monitoramento de servidores com o OpManager

Versões compatíveis para servidores WindowsVersões compatíveis para servidores LinuxProtocolos de monitoramento de servidores
Windows NT, 2000Red hat enterpriseSNMP v1 e v2c
Windows 2003SUSESNMP v3
Windows 2008, 2008 R2UbuntuCLI
Windows 2012, 2012 R2FedoraWMI
Windows 2016DebianPrismAPI
Windows 2019CentOSAPIs

Perguntas frequentes (FAQs) sobre monitoramento de servidores

Quais são os requisitos de monitoramento de servidores no OpManager?


O OpManager não tem requisitos específicos para o monitoramento de servidores. Os servidores estão incluídos na licença regular do OpManager, baseada em dispositivos. É possível monitorar métricas ilimitadas por servidor na licença, incluindo: uptime, desempenho, hardware e as interfaces conectadas.

Para descobrir, identificar, classificar e monitorar servidores, o OpManager usa protocolos como

É necessário fornecer as credenciais dos respectivos servidores para que o OpManager possa acessá-los e coletar dados. Como alternativa, é possível instalar um agente de monitoramento leve.

Qual é o intervalo de monitoramento recomendado para o monitoramento de servidores?


Como configurar alarmes para métricas de desempenho de servidores no OpManager?


Como os thresholds adaptativos orientados por ML calculam com precisão os thresholds de todas as métricas?


Além de uptime e desempenho, o que o OpManager pode monitorar em servidores?


Como as visualizações de racks e de plantas de data center ajudam?


O OpManager é adequado para servidores domésticos ou para modelos de servidores de data center?


Por que o OpManager é considerado uma das melhores opções para monitoramento de servidores?


Monitoramento de servidores completo com um console unificado

Preferido por clientes do mundo todo


“Implementação simples, excelente suporte e ferramenta de menor custo - Líder de equipe, setor de serviços de TI”

Função do avaliador: Infraestrutura e operações

Porte da empresa: US$ 500 milhões a US$ 1 bilhão

Usamos o OpManager desde 2011 e a experiência geral tem sido excelente. A ferramenta tem papel vital em gerar valor para a nossa organização e para os clientes que atendemos. O suporte é excelente e a equipe assume total responsabilidade pela resolução dos problemas. A inovação não para e é claramente visível nas versões mais recentes.

“OpManager: 10 passos à frente da concorrência, a um passo de ser inigualável - Gerente de serviços de rede, órgão governamental”

Função do avaliador: Infraestrutura e operações

Porte da empresa: 5.000 a 50.000 funcionários

Tenho um relacionamento de longa data com a ManageEngine. O OpManager sempre careceu de um ou dois recursos que o tornariam realmente a melhor ferramenta do mercado, mas, no geral, é o produto mais completo e fácil de usar do mercado.

“Implementação simples, com um catálogo rico em recursos; o suporte tem espaço para melhorias - Gerente de NOC, setor de serviços de TI”

Função do avaliador: Gerenciamento de programas e portfólio

Porte da empresa: US$ 500 milhões a US$ 1 bilhão

O fornecedor deu apoio durante as fases de implementação e de POC, fornecendo licenças de avaliação. Solicitações de recursos e feedbacks costumam ser atendidos com rapidez. Houve apoio suficiente do fornecedor durante a implementação. Após a implantação, o suporte é mais que adequado, embora o fornecedor pudesse fazer algumas melhorias.

“Ótima ferramenta de monitoramento - CIO do setor financeiro”

Função do avaliador: CIO

Porte da empresa: US$ 1 bilhão a US$ 3 bilhões

A ManageEngine oferece um conjunto de ferramentas que melhorou a disponibilidade das nossas aplicações internas. Com monitoramento, gerenciamento e alertas, conseguimos atingir o desempenho máximo no nosso data center.

“Implementação simples, fácil de usar. Muito intuitivo. - Engenheiro principal em serviços de TI”

Função do avaliador: Arquitetura corporativa e inovação tecnológica

Porte da empresa: US$ 250 milhões a US$ 500 milhões


O suporte da ManageEngine foi ágil em responder a todas as nossas dúvidas.

Capterra
Getapp
Software Advice
G2
Altaleb Alshenqiti

“O OpManager me ajuda a monitorar todos os aspectos do data center e dos equipamentos, como servidores, switches e roteadores. É rápido, intuitivo e centralizado, e não é preciso ser especialista para usar o OpManager.”

Altaleb Alshenqiti

NGHA

Donald Stewart

“Donald Stewart, gerente de TI da Crest Industries, está satisfeito com o OpManager da ManageEngine como software de monitoramento de rede de ponta a ponta. É fácil de usar e oferece gerenciamento de falhas e de desempenho para roteadores.”

Donald Stewart

Gerente de TI, Crest Industries

John Rosser

“John Rosser, gerente de MIS da Yale Chase, fala sobre a natureza proativa do OpManager da ManageEngine e sobre o valor que sua organização obteve com ele.”

John Rosser

Gerente de MIS