Disaster recovery planning: Panduan lengkap menyusun strategi pemulihan bencana
Satu masalah teknis yang kecil bisa berakibat fatal bagi organisasi. Mungkin awalnya hanya terjadi di satu titik, lalu menyebar menjadi tidak terkendali sehingga menganggu operasional dan layanan.
Sebelum kejadian ini terjadi, organisasi harus bersiap. Persiapan dilakukan dengan merancang disaster recovery planning (DRP) yang menyediakan kebijakan, prosedur, dan tindakan untuk membantu organisasi memulihkan sistem informasi ketika terjadi gangguan besar. Dalam konteks modern, gangguan ini bukan hanya bencana alam saja, tetapi juga berupa serangan siber seperti ransomware atau kerusakan pada hardware.
Kini, disaster recovery merupakan prioritas strategis yang menjadi kewajiban bagi setiap organisasi. Bagaikan payung sebelum hujan, disaster recovery planning membantu menjaga organisasi dari kerugian yang lebih besar.
Apa itu disaster recovery planning?
Disaster recovery planning adalah serangkaian panduan dan prosedur yang dirancang untuk membantu aplikasi dan sistem kembali aktif setelah gangguan seperti serangan siber, bencana alam, atau kegagalan sistem.
Tujuan rencana disaster recovery adalah agar organisasi tidak perlu mengalami gangguan atau downtime dalam waktu lama. Dengan panduan yang ada dalam disaster recovery plan, organisasi bisa bertindak cepat ketika ada gangguan.
Disaster recovery planning pada IT biasanya mencakup berbagai aspek seperti prosedur pemulihan, mekanisme backup dan recovery data, serta peran dan tanggung jawab tim yang terlibat dalam pemulihan.
Mengapa disaster recovery planning penting?
Disaster recovery planning membantu meminimalkan dampak dari gangguan pada sistem informasi. Melalui DRP, organisasi dapat:
Menjaga data agar tidak hilang, corrupt, atau dicuri. Hal ini penting karena organisasi menghasilkan banyak sekali data setiap hari. Jika data-data tersebut terjaga dengan aman, organisasi bisa menghindari konsekuensi legal dan finansial.
Meminimalkan kerugian finansial yang timbul akibat downtime. Ketika downtime terjadi, layanan yang tidak dapat diakses bisa menyebabkan penurunan revenue dan kehilangan produktivitas.
Menjaga reputasi organisasi dan kepercayaan pelanggan. DRP bisa menjadi tameng yang menunjukkan bahwa organisasi memiliki komitmen terhadap integritas, privasi, dan kontinuitas data.
Komponen utama disaster recovery planning
Untuk memastikan business continuity, disaster recovery plan harus komprehensif. Biasanya, strategi disaster recovery mencakup beberapa komponen utama berikut.
Peran dan tanggung jawab tim
DRP harus mencantumkan peran dan tanggung jawab tim dengan jelas agar ketika insiden terjadi, tidak ada saling lempar tanggung jawab.
Jabatan yang memiliki peran penting dalam disaster recovery misalnya:
Disaster recovery leader bertugas mengoordinasikan proses recovery dan mengambil keputusan penting.
Business liaison bertugas mengomunikasikan status recovery kepada departemen non-IT.
IT operations bertanggung jawab menjalankan proses pemulihan infrastruktur, aplikasi, dan data.
Tim komunikasi bertanggung jawab menyampaikan perkembangan, kendala, dan hasil recovery kepada pihak terkait.
Risk assessment dan business impact analysis (BIA)
Risk assessment bertujuan untuk memahami risiko yang bisa memicu gangguan di organisasi. Risiko tersebut dapat berupa ancaman siber seperti ransomware, masalah gangguan fisik seperti mati listrik atau bencana alam, hingga risiko operasional seperti human error atau kesalahan konfigurasi jaringan.
Sementara itu, business impact analysis (BIA) digunakan untuk mengetahui dampak operasional, finansial, dan reputasi yang mungkin terjadi akibat gangguan. BIA juga membantu organisasi menentukan prioritas fungsi bisnis dan layanan IT yang harus segera dipulihkan.
Recovery objectives
Pada umumnya, ada dua metrik terkait recovery yang harus dicantumkan dalam disaster recovery planning, yaitu recovery time objective (RTO) dan recovery point objective (RPO).
RTO merupakan durasi maksimum gangguan atau downtime yang dapat ditoleransi.
RPO merupakan jumlah kehilangan data maksimal yang masih bisa dapat diterima oleh organisasi. Jumlah ini diukur berdasarkan rentang waktu.
RTO dan RPO dapat memengaruhi frekuensi backup dan strategi replikasi. Semakin rendah target RTO dan RPO, umumnya semakin besar investasi teknologi yang dibutuhkan.
Inventarisasi aset dan dependency mapping
DRP perlu dilengkapi dengan inventarisasi aset IT yang lengkap dan selalu diperbarui. Aset ini mencakup server dan infrastruktur, aplikasi dan database, perangkat jaringan, layanan dan akun cloud, sistem penyimpanan dan data, hingga layanan keamanan dan identitas.
Tetapi, memiliki daftar aset saja tidak cukup. Organisasi juga perlu mengetahui hubungan ketergantungan antar-aset melalui dependency mapping. Pemetaan ini bermanfaat bagi organisasi untuk menentukan sistem mana yang harus dipulihkan terlebih dahulu dan seperti apa urutannya.
Backup, perlindungan data, dan redundansi
DRP juga mencakup perlindungan data. Di dalam DRP, harus ada pembahasan tentang data dan sistem yang perlu di-backup, seberapa sering backup dilakukan, di mana backup disimpan, dan bagaimana data tersebut akan dipulihkan.
Selain itu, organisasi juga dapat menyiapkan sistem redundan yang siap mengambil alih ketika sistem utama mengalami kegagalan.
Recovery infrastruktur dan strategi failover
Bagaimana jika server utama tidak dapat berjalan ketika terjadi gangguan? Organisasi perlu menyiapkan beberapa strategi seperti:
Failover untuk memindahkan operasional dari server utama ke server recovery ketika terjadi gangguan.
Failback untuk mengembalikan operasional ke server utama setelah sistem tersebut berhasil dipulihkan.
Secondary data center yang ditempatkan secara terpisah dari lingkungan utama untuk mengurangi risiko terdampak gangguan.
Disaster recovery as a service (DRaaS) yang memanfaatkan layanan cloud untuk menyediakan dan mengelola environment recovery tanpa organisasi harus membangun seluruh infrastruktur DR secara mandiri.
Prosedur recovery dan pengujian
DRP harus menerjemahkan strategi recovery menjadi prosedur yang jelas dan dapat dijalankan. Prosedur ini dituang dalam dokumentasi yang berisi panduan lengkap.
Akan tetapi, dokumentasi tetap harus diuji untuk memastikan bahwa prosedur yang terdapat di dalamnya benar-benar dapat dijalankan ketika dibutuhkan. Cara mengujinya bisa dengan tabletop exercise, simulated failover, atau full-scale drill.
Selain itu, DRP juga harus diperlakukan sebagai dokumen yang terus berkembang. Seiring perubahan organisasi terutama terkait infrastruktur, aplikasi, dan personel, prosedur recovery yang ada bisa saja sudah tidak relevan. Karena itu, DRP perlu diperbarui secara berkala.
Tantangan yang muncul dalam disaster recovery planning
Ketika merancang maupun mengimplementasikan disaster recovery planning, organisasi juga dapat menemui berbagai tantangan sebagai berikut:
Envinronment hybrid yang kompleks: Ekosistem IT modern mencakup infrastruktur on-premise, platform cloud, hingga aplikasi SaaS. Mengelola lingkungan ini memunculkan tantangan tersendiri karena sistem yang terdistribusi.
Keterbatasan budget: Untuk menciptakan infrastruktur yang redundan dan menjaga recovery, organisasi membutuhkan investasi biaya yang tidak sedikit.
Kurangnya visibilitas: Organisasi dengan infrastruktur kompleks mungkin memiliki keterbatasan visibilitas terhadap dependensi aplikasi serta kondisi kesehatan infrastruktur.
Pengujian tidak konsisten: Masih banyak organisasi yang sudah menciptakan disaster recovery plan, tetapi tidak diuji secara berkala.
Serangan siber yang terus berkembang: Perkembangan serangan siber membuat strategi disaster recovery tradisional sudah tidka lagi relevan.
Apa saja best practice dalam membuat disaster recovery plan?
Berikut beberapa best practice yang dapat diterapkan untuk meningkatkan efektivitas disaster recovery planning.
1. Menyelaraskan disaster recovery dengan prioritas bisnis
Target dan strategi recovery harus selaras dengan prioritas bisnis dan dampak yang mungkin ditimbulkan oleh downtime.
Untuk menyelaraskannya, organisasi dapat menggunakan hasil dari business impact analysis (BIA). Dari hasil ini, organisasi dapat melihat sistem dan proses mana yang paling penting bagi operasional lalu menetapkan RTO dan RPO yang sesuai.
2. Menerapkan pendekatan berbasis risiko
Tidak semua sistem membutuhkan tingkat perlindungan yang sama. Seperti yang diketahui dalam risk assessment, setiap sistem memiliki tingkat risiko yang berbeda-beda, ada yang berisiko tinggi maupun berisiko rendah.
Tingkat proteksi dan respons recovery pun dapat disesuaikan dengan tingkat risiko tersebut. Misalnya, sistem yang mendukung transaksi pelanggan membutuhkan recovery sangat cepat. Lalu, data yang memiliki persyaratan compliance tertentu mungkin membutuhkan mekandisme perlindungan tambahan.
3. Membangun cyber resilience ke dalam strategi disaster recovery
Semakin besar dan seringnya serangan siber membuat organisasi perlu membangun cyber resilience ke dalam DRP. Hal ini bisa dilakukan dengan penerapan immutable backup, MFA, Zero Trust, privileged access control, maupun segmentasi jaringan.
4. Mengotomatiskan proses recovery
Proses recovery yang terlalu bergantung pada tindakan manual dapat memperlambat pemulihan dan meningkatkan risiko human error.
Organisasi sebaiknya memanfaatkan automasi terutama dalam proses backup, infrastructure provisioning, failover, workload recovery, dan recovery validation.
5. Menguji, memvalidasi, dan memperbarui DRP secara berkala
DRP yang tidak pernah diuji belum tentu dapat berfungsi ketika benar-benar dibutuhkan. Karena itu, organisasi perlu melakukan tabletop exercises, simulated failovers, hingga full-scale drill secara berkala. Dengan pengujian, organisasi dapat menemukan gap sebelum terjadi gangguan yang sebenarnya. Jika ada hal yang kurang, maka DRP pun juga dapat diperbarui.
Bagaimana ManageEngine mendukung disaster recovery planning?
ManageEngine menyediakan berbagai kapabilitas yang mendukung disaster recovery planning, mulai dari backup dan data recovery hingga automasi.
1. Backup data
RecoveryManager Plus membantu melindungi data organisasi dengan kemampuan backup dan restore untuk Active Directory, Azure Active Directory, Microsoft 365, Google Workspace, dan Exchange.
Solusi ini mendukung full dan incremental backup, penjadwalan backup otomatis, dan penyimpanan backup yang fleksibel. Backup dapat disimpan di lokasi on-premise maupun cloud.
2. Granular data recovery
Ketika terjadi gangguan, organisasi tidak selalu perlu memulihkan seluruh environment. RecoveryManager Plus memungkinkan recovery menyeluruh maupun sebagian, sehingga administrator dapat memulihkan data atau objek tertentu sesuai kebutuhan.
Kemampuan ini membantu mempercepat proses pemulihan dan mengurangi downtime, terutama ketika organisasi perlu memulihkan data tertentu setelah insiden seperti ransomware.
3. Application discovery dan dependency mapping
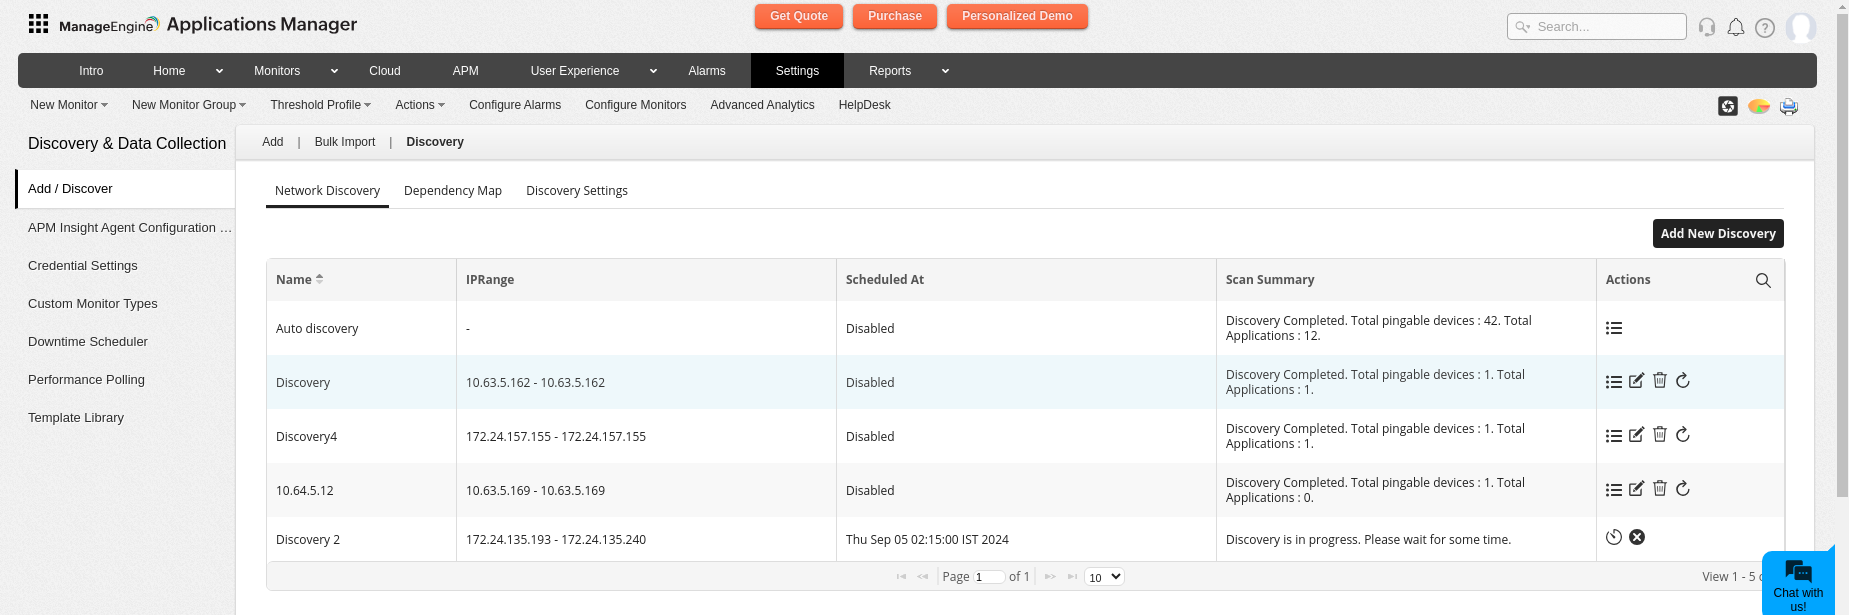
Sebelum melakukan recovery, tim IT perlu memahami apa saja yang terdampak dan bagaimana sistem saling bergantung.
Applications Manager dengan Application Discovery and Dependency Mapping (ADDM) dapat menemukan aplikasi, server, database, dan resource terkait, kemudian memetakan dependency di antara komponen tersebut.
Informasi ini membantu tim memahami hubungan antar-sistem dan menentukan komponen yang perlu dipulihkan serta urutan recovery yang tepat.
4. Availability dan performance monitoring
Setelah sistem dipulihkan, tim IT perlu memastikan bahwa layanan benar-benar tersedia dan berfungsi sebagaimana mestinya.
Applications Manager menyediakan monitoring terhadap aplikasi, server, database, dan infrastruktur, termasuk informasi mengenai availability dan performa. Monitoring ini membantu tim mendeteksi masalah yang dapat menyebabkan downtime dan memantau kondisi environment selama maupun setelah proses recovery.a
5. Monitoring replication dan high availability
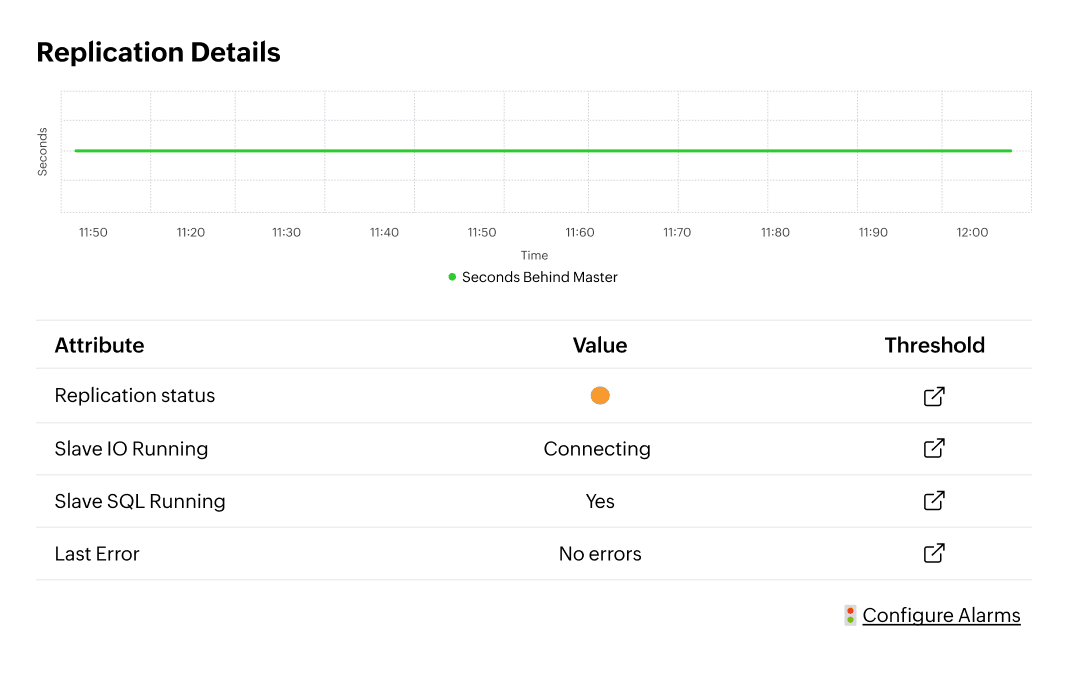
Untuk workload yang menggunakan replication, clustering, atau high-availability architecture, kondisi sistem redundan perlu terus dipantau agar siap digunakan ketika primary environment mengalami gangguan.
Applications Manager menyediakan kemampuan monitoring untuk replication, clustering, dan HA environments, sehingga tim IT dapat memperoleh visibilitas terhadap kondisi primary dan secondary components serta mendeteksi masalah yang dapat memengaruhi kesiapan recovery.
6. Automated backup dan monitoring
Automation dapat mengurangi ketergantungan pada proses manual yang berpotensi menyebabkan human error.
RecoveryManager Plus memungkinkan backup dijadwalkan secara otomatis, sementara Applications Manager dapat menggunakan monitoring dan alerting untuk membantu tim mengetahui masalah pada aplikasi maupun infrastruktur tanpa harus melakukan pemeriksaan manual secara terus-menerus.
Kesimpulan
Disaster recovery planning merupakan bagian penting dari strategi ketahanan bisnis di tengah berbagai risiko yang dapat mengganggu operasional IT, mulai dari kegagalan infrastruktur dan human error hingga serangan siber dan bencana alam.
DRP yang efektif tidak hanya berfokus pada backup, tetapi juga mencakup identifikasi risiko, penentuan prioritas aset, recovery objectives, strategi failover, prosedur pemulihan, serta pengujian dan evaluasi secara berkala.
ManageEngine dapat membantu organisasi dalam merencanakan dan mengimplementasikan disaster recovery strategy. Melalui RecoveryManager Plus dan Applications Manager, organisasi dapat melindungi data, memantau infrastruktur dan aplikasi, serta mendukung proses recovery secara lebih efektif.
Pelajari selengkapnya melalui demo dengan tim kami!